
딥러닝으로 나스닥100 예측하는 방법, LSTM부터 Transformer까지
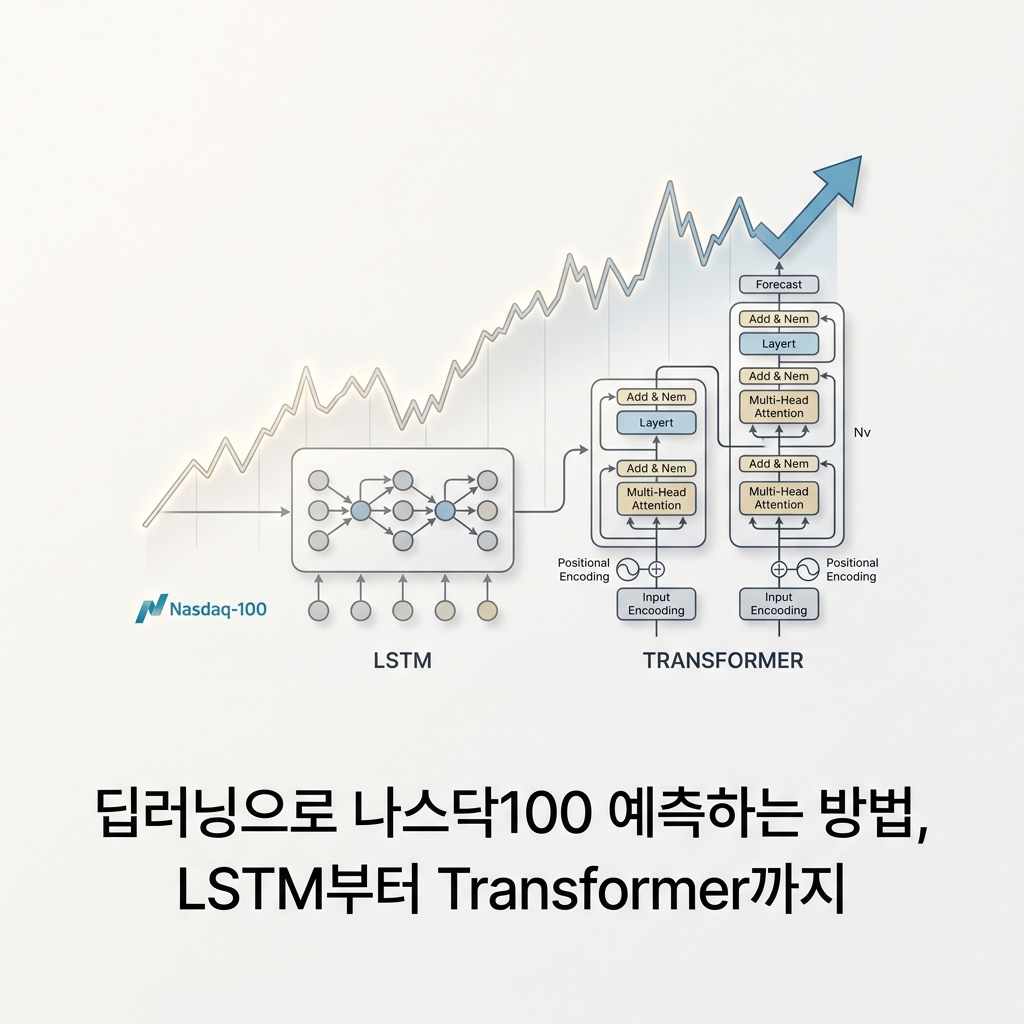
주식시장의 움직임을 인공지능으로 예측할 수 있을까요? 최근 AI 기술이 빠르게 발전하면서 과거 주가 데이터를 학습해 미래 움직임을 분석하는 딥러닝 주가 예측에 관심이 높아지고 있습니다. 특히 나스닥100은 글로벌 기술기업의 움직임을 반영하는 대표적인 지수이기 때문에 금융 시계열 분석을 공부할 때 흥미로운 대상입니다.
하지만 딥러닝이 내일의 주가를 정확하게 알려주는 것은 아닙니다. 금융시장은 금리, 환율, 기업 실적, 경제지표, 투자심리 등 다양한 변수의 영향을 받기 때문입니다. 따라서 딥러닝은 과거 데이터에서 사람이 쉽게 발견하기 어려운 패턴을 학습해 향후 움직임을 확률적으로 분석하는 도구로 이해하는 것이 좋습니다.
나스닥100 예측에 활용되는 딥러닝 모델
나스닥100 예측에 활용할 수 있는 대표적인 모델로 LSTM, CNN, Transformer가 있습니다. 각각 데이터를 분석하는 방식에 차이가 있습니다.
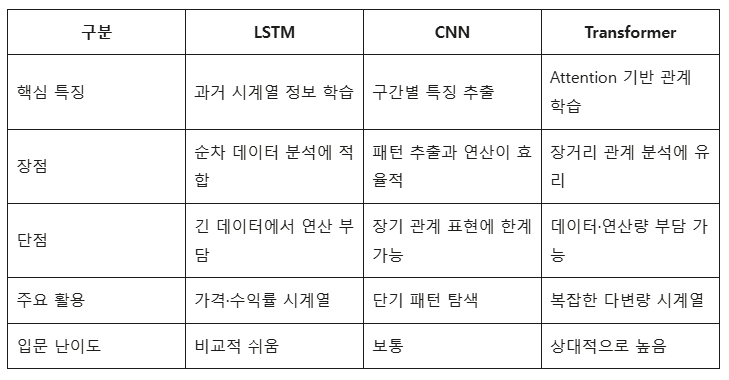
LSTM(Long Short-Term Memory)은 과거 정보를 순차적으로 처리할 수 있어 딥러닝 주가 예측에서 널리 활용되는 모델입니다. CNN은 일정 기간의 데이터에서 반복되는 특징을 추출하는 데 활용할 수 있습니다.
Transformer는 Attention 구조를 이용해 서로 다른 시점의 관계를 학습합니다. 비교적 긴 시계열이나 여러 변수를 함께 분석하는 연구에서도 활용되고 있습니다.
다만 어떤 모델이 항상 가장 정확하다고 단정할 수는 없습니다. 같은 LSTM이라도 데이터 기간, 입력 변수, 학습 방법에 따라 결과가 달라질 수 있기 때문에 동일한 조건에서 여러 모델을 비교해야 합니다.
딥러닝 주가 예측 모델은 어떻게 만들까?
먼저 나스닥100의 시가, 고가, 저가, 종가, 거래량과 같은 데이터를 준비합니다. 여기에 이동평균선, RSI, MACD 같은 기술적 지표를 추가하거나 금리, 환율 등 외부 변수를 함께 사용할 수도 있습니다.
다음으로 결측값과 이상치를 확인하고 필요한 경우 데이터를 정규화합니다. 이후 일정 기간을 하나의 입력 구간으로 만드는 시계열 윈도우를 구성합니다.
예를 들어 과거 60거래일 데이터를 입력하고 다음 거래일의 수익률이나 상승·하락 방향을 예측하도록 모델을 만들 수 있습니다. 여기서 60일은 하나의 예시일 뿐이며 20일, 60일, 120일 중 어떤 기간이 적합한지는 직접 실험해 확인해야 합니다.
특히 금융 시계열에서는 **데이터 누수(Data Leakage)**를 조심해야 합니다. 미래 시점에서만 알 수 있는 정보가 학습 과정에 포함되면 실제보다 예측 성능이 높게 나타날 수 있습니다. 따라서 학습·검증·테스트 데이터를 시간 순서에 따라 구분하는 것이 중요합니다.
예측 정확도가 높으면 투자수익도 높을까?
반드시 그렇지는 않습니다. 모델이 과거 데이터에 지나치게 맞춰지는 과적합(Overfitting)이 발생하면 학습 데이터에서는 좋은 결과가 나오더라도 새로운 시장에서는 성능이 떨어질 수 있습니다.
따라서 예측 정확도 하나만 보는 것보다 별도의 테스트 데이터와 백테스트를 활용해 검증해야 합니다. 실제 투자 전략을 가정한다면 거래비용과 슬리피지까지 고려할 필요가 있습니다.
또한 시장 환경은 계속 변합니다. 금리와 경기 상황, 시장을 주도하는 업종이 달라지면 과거에 효과적이었던 패턴이 약해질 가능성도 있습니다.
Google Colab으로도 시작할 수 있다
딥러닝 주가 예측을 공부한다고 처음부터 고가의 컴퓨터를 준비할 필요는 없습니다. Google Colab을 활용하면 웹 브라우저에서 Python을 실행하고 제공되는 컴퓨팅 자원을 이용해 간단한 딥러닝 모델을 실습할 수 있습니다. 무료 환경의 자원과 사용 한도는 상황에 따라 달라질 수 있습니다.
TensorFlow, Keras, PyTorch, pandas, scikit-learn 같은 오픈소스 라이브러리를 함께 사용하면 데이터 전처리부터 모델 학습과 평가까지 구현할 수 있습니다.
처음에는 간단한 LSTM으로 기준 모델을 만든 뒤 같은 데이터로 CNN과 Transformer의 결과를 비교해보는 것도 좋은 학습 방법입니다.
결국 나스닥100 딥러닝 예측의 핵심은 미래 가격을 완벽하게 맞히는 데 있지 않습니다. 데이터를 통해 시장의 패턴을 탐색하고, 모델이 어느 상황에서 작동하고 어느 상황에서 실패하는지를 검증하는 과정에 더 큰 의미가 있습니다.
딥러닝 결과를 실제 투자에 참고한다면 하나의 예측값에 의존하기보다 투자 비중, 자산 배분, 손실 관리 등을 함께 고려해야 합니다.
참고자료: Nasdaq Nasdaq-100 공식 자료, TensorFlow Time Series Forecasting Tutorial, Google Colab FAQ
※ 본 글은 딥러닝과 금융 시계열 분석에 관한 일반적인 정보 제공을 목적으로 하며 특정 주식, ETF 또는 금융상품의 매수·매도를 권유하는 투자 자문이 아닙니다.
금알남


댓글 0
첫 댓글을 남겨보세요.