
LSTM이 GARCH보다 정확하다? 예측 성능 비교할 때 주의할 점
LSTM과 GARCH의 예측 결과를 비교할 때 단순히 RMSE나 MAE가 낮은 모델만 선택하면 놓치는 부분이 있습니다. 비선형 패턴을 잘 잡는 딥러닝과 변동성 군집 특성을 반영하는 전통 통계 모델은 근본적인 작동 방식이 다르기 때문입니다. 따라서 두 모델의 목적부터 예측 대상, 데이터 분할, 데이터 누수, 과적합, 실제 투자 활용 가능성까지 함께 확인해야 합니다. 특히 훈련 과정에서 미래 데이터가 섞이는 데이터 누수나 백테스팅에서의 거래 비용 반영 여부는 실전 성과를 좌우하는 핵심 요소입니다. 관련 내용을 한 번에 점검할 수 있도록 꼼꼼히 정리해두었으니, 현재 시계열 모델을 직접 테스트하고 계시다면 시행착오를 줄이는 데 큰 도움이 될 것입니다.
LSTM의 오차가 더 작으면 GARCH보다 좋은 모델일까?
LSTM과 GARCH를 이용해 금융 데이터를 분석하다 보면 꽤 흥미로운 결과를 만날 때가 있습니다.
같은 금융 데이터를 이용해 예측 모델을 만들었는데 LSTM의 RMSE와 MAE가 GARCH보다 낮게 나오는 것입니다.
그러면 자연스럽게 이런 생각이 듭니다.
“역시 딥러닝이 전통적인 통계 모델보다 정확한 것 아닐까?”
하지만 여기서 바로 결론을 내리면 안 됩니다.
금융 시계열에서는 오차가 더 작다는 사실과 실제 투자에서 더 유용한 모델이라는 판단이 반드시 같은 의미는 아니기 때문입니다.
금융시장은 잡음이 많고 시장 환경도 계속 변합니다. 특정 기간에서 잘 작동했던 패턴이 이후에도 그대로 유지된다고 보기 어렵습니다.
그래서 LSTM과 GARCH를 비교할 때는 단순히 “누가 이겼나?”보다 먼저 확인해야 할 것이 있습니다.
바로 이것입니다.
애초에 두 모델에게 같은 문제를 풀게 했는가?
이 질문부터 시작해야 합니다.
LSTM과 GARCH 차이, 표로 먼저 비교해보겠습니다
LSTM과 GARCH의 예측 결과를 비교하기 전에 두 모델의 성격부터 이해할 필요가 있습니다.
LSTM은 복잡한 시계열 패턴을 학습할 수 있는 신경망 구조이고, GARCH는 금융시장에서 시간에 따라 달라지는 조건부 분산과 변동성을 모델링하는 데 널리 사용되는 통계적 시계열 모델입니다.
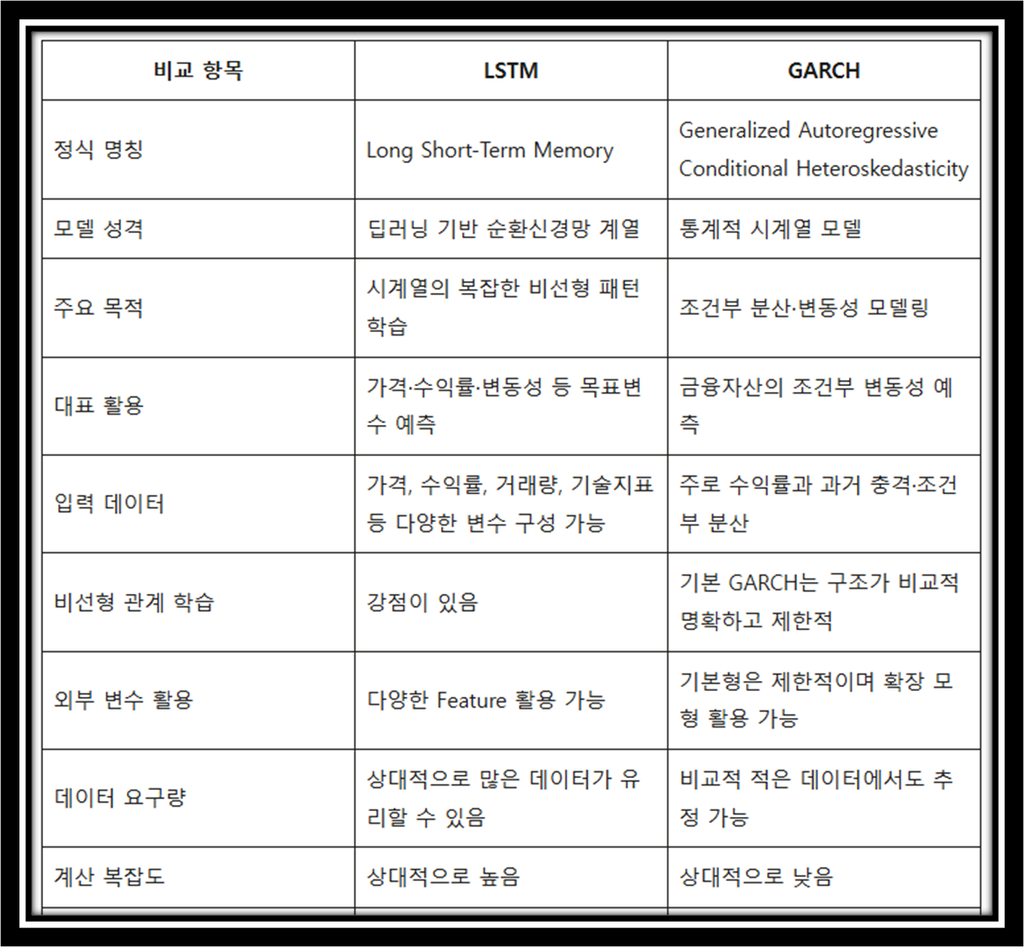
여기서 특히 중요한 것은 단순히 “LSTM은 딥러닝이고 GARCH는 통계 모델이다”라는 차이가 아닙니다.
무엇을 예측하도록 설계했느냐가 중요합니다.
예를 들어 LSTM에 과거 종가, 거래량, 수익률, 이동평균 등을 입력하고 다음 날 종가를 예측하게 만들었다고 해보겠습니다.
반면 GARCH(1,1)를 이용해 다음 날의 조건부 분산을 예측했다면 두 모델에서 모두 숫자는 나오지만 이를 단순 비교하기는 어렵습니다.
서로 다른 문제를 풀게 해놓고 점수만 비교했을 수 있기 때문입니다. 따라서 제대로 비교하려면 먼저 Target을 통일해야 합니다.
변동성 예측 성능을 비교한다면 LSTM도 동일하게 정의한 미래 변동성을 Target으로 학습시키고, GARCH도 동일한 기간에 대한 변동성을 예측하도록 설계해야 합니다.
Forecast Horizon도 맞춰야 합니다.
1일 후 변동성과 20일 후 변동성을 예측하는 것은 같은 문제가 아닙니다.
결국 첫 번째 질문은 “어느 모델의 숫자가 더 좋은가?” 가 아니라 “두 모델에게 정말 같은 문제를 풀게 했는가?” 입니다.
LSTM 성능이 너무 좋다면 데이터 누수부터 확인하세요
LSTM 예측 결과가 지나치게 좋을 때 가장 먼저 확인해볼 부분 중 하나가 데이터 누수(Data Leakage)입니다.
금융 시계열에서는 특히 조심해야 합니다.
일반적인 머신러닝 데이터처럼 전체 데이터를 무작위로 섞은 뒤 Train/Test로 나누면 시간 순서가 무너질 수 있습니다.
미래 데이터가 어떤 형태로든 학습 과정에 들어갔다면 실제 투자 시점에는 알 수 없었던 정보를 이용해 과거를 맞힌 셈이 됩니다.
특히 다음 다섯 가지는 꼭 확인해보는 것이 좋습니다.
- Train/Test 데이터를 시간 순서대로 분리했는가?
- 정규화 과정에서 전체 데이터 정보를 미리 사용하지 않았는가?
- Feature를 만들 때 미래 가격이나 미래 수익률이 들어가지 않았는가?
- Test 결과를 보면서 하이퍼파라미터를 반복 수정하지 않았는가?
- Rolling 또는 Walk-Forward 방식에서도 성능이 유지되는가?
예를 들어 StandardScaler나 MinMaxScaler를 전체 데이터에 먼저 Fit한 뒤 Train/Test를 나눴다면 Test 데이터의 분포 정보가 학습 과정에 간접적으로 들어갈 수 있습니다.
Scaler 역시 Training Data에 맞춰 Fit하고 이후 Validation과 Test 데이터에는 Transform만 적용하는 식으로 시간 순서를 지키는 것이 중요합니다.
금융 시계열에서는 이 작은 차이가 백테스트 결과를 상당히 다르게 만들 수 있습니다.
RMSE 하나만으로 LSTM과 GARCH의 승자를 정하지 마세요
모델 비교에서 흔히 사용하는 지표가 있습니다.
- MAE: 평균 절대 오차
- MSE: 평균 제곱 오차
- RMSE: 평균 제곱근 오차
- MAPE: 평균 절대 백분율 오차
모두 중요한 지표입니다.
하지만 금융 예측에서는 이것만으로 충분하지 않을 수 있습니다.
예를 들어 모델 A의 가격 예측 RMSE가 모델 B보다 낮다고 해보겠습니다.
그런데 정작 상승과 하락 방향을 자주 틀린다면 실제 매매 전략에서는 전혀 다른 결과가 나올 수 있습니다.
반대로 예측값 자체에는 어느 정도 오차가 있어도 중요한 시장 움직임이나 변동성 확대 구간을 상대적으로 잘 포착하는 모델이 목적에 따라 더 유용할 수도 있습니다.
따라서 예측 목적에 따라 RMSE와 MAE 외에도 방향성 적중 여부, 변동성 예측력 등을 함께 살펴볼 필요가 있습니다.
두 모델의 예측오차 차이가 통계적으로 의미가 있는지 살펴볼 때 활용되는 방법 중 하나가 Diebold-Mariano 검정입니다.
다만 이 검정 역시 적용 조건과 해석에 주의해야 합니다.
단순히 특정 지표가 조금 낮게 나왔다고 해서 “LSTM이 GARCH보다 우수하다.” 라고 일반화하기보다는 “이번 데이터와 설정, Out-of-Sample 구간에서는 LSTM의 해당 예측오차가 더 낮았다.”
정도로 결과의 범위를 명확하게 표현하는 편이 적절합니다.
LSTM은 과적합을 특히 주의해서 봐야 합니다
LSTM의 강점은 동시에 주의해야 할 부분이 될 수 있습니다.
복잡한 패턴을 학습할 능력이 높다는 것은 의미 있는 구조뿐 아니라 데이터 속 우연한 잡음까지 학습할 가능성이 있다는 의미이기도 합니다.
특히 금융 데이터에서는 이 문제가 중요합니다.
Training Loss가 매우 낮다고 바로 좋은 모델이라고 판단하기보다 Validation Loss와 Test 성능을 함께 확인해야 합니다.
시장 국면도 살펴봐야 합니다.
상승장에서만 좋은 모델인지, 하락장이나 변동성이 급격하게 확대되는 시기에도 성능이 유지되는지 확인할 필요가 있습니다.
예를 들어 S&P 500 ETF인 SPY, 나스닥100 ETF인 QQQ 또는 AAPL, NVDA 같은 개별 종목을 이용해 모델을 실험한다고 해보겠습니다.
특정 강세장 구간만 학습하고 테스트하면 그 시장 환경에 적합한 모델이 만들어질 수 있습니다.
하지만 시장 환경이 달라지면 기존 패턴이 약해질 가능성이 있습니다.
따라서 금융 예측에서는 한 번의 Train/Test Split보다 여러 시점을 이동하면서 반복적으로 검증하는 Walk-Forward 방식이 의미가 있습니다.
예측 정확도와 실제 투자 수익률은 다른 문제입니다
실제 투자를 생각한다면 이 부분은 더욱 중요합니다.
예측 정확도가 높다 = 투자 수익률이 높다
이 등식은 자동으로 성립하지 않습니다.
예를 들어 내일 종가를 상당히 비슷하게 예측하는 모델이 있다고 가정해보겠습니다.
실제 투자에서는 또 다른 조건이 들어갑니다. 매수·매도 기준, 거래비용, 슬리피지, 회전율, 포지션 크기, 손실 관리 등이 필요합니다.
SPY, QQQ, AAPL, NVDA 같은 실제 거래 자산을 대상으로 모델을 테스트한다면 단순 가격 오차뿐 아니라 그 예측을 어떤 규칙으로 투자 신호로 변환했는지까지 별도로 검증해야 합니다.
따라서 저는 모델을 평가할 때 세 가지 질문을 분리해서 보는 것이 좋다고 생각합니다.
- 통계적으로 예측을 잘했는가?
- 보지 못한 새로운 데이터에서도 성능이 유지됐는가?
- 실제 매매 규칙으로 변환했을 때도 경제적으로 의미가 있었는가?
세 질문은 비슷해 보이지만 서로 다른 문제입니다.
그렇다면 LSTM과 GARCH는 어떻게 비교해야 할까?
LSTM과 GARCH를 직접 비교하는 실험을 설계한다면 최소한 다음 순서로 점검해보는 것이 좋습니다.
첫째, 예측 목표를 통일합니다.
가격을 예측할 것인지, 수익률을 예측할 것인지, 변동성을 예측할 것인지 먼저 결정해야 합니다.
둘째, Forecast Horizon을 동일하게 맞춥니다.
1일 후 예측과 20일 후 예측을 동일한 조건처럼 비교하면 안 됩니다.
셋째, 학습·검증·테스트 데이터를 시간 순서대로 분리합니다.
가능하다면 Walk-Forward 또는 Rolling Window 방식도 함께 검토합니다.
넷째, 동일한 Out-of-Sample 구간에서 비교합니다.
모델마다 유리한 시장 구간을 선택하면 비교 결과의 의미가 크게 떨어질 수 있습니다.
다섯째, 하나의 평가지표에만 의존하지 않습니다.
MAE, RMSE 등 연구 목적에 맞는 여러 지표를 살펴보고 필요한 경우 예측오차 차이에 대한 통계적 검정도 검토합니다.
여섯째, LSTM은 반복 실험을 확인합니다.
신경망은 초기값과 학습 조건 등에 따라 결과가 달라질 수 있으므로 한 번 실행한 결과만으로 결론을 내리지 않는 것이 좋습니다.
일곱째, 실제 투자 목적이라면 경제적 성과를 별도로 검증합니다.
거래비용과 현실적인 매매 조건을 포함한 Out-of-Sample 백테스트를 별도로 진행해야 합니다.
여기까지 확인했는데도 LSTM의 성능이 여러 구간에서 지속적으로 좋다면 그 결과는 훨씬 흥미롭게 볼 수 있습니다.
반대로 GARCH가 특정 변동성 예측 구간에서 더 안정적인 모습을 보인다면 그것 역시 중요한 결과입니다.
그리고 두 모델의 장점이 서로 다르게 나타난다면 꼭 둘 중 하나만 선택할 필요도 없습니다.
GARCH에서 얻은 조건부 변동성 정보를 LSTM의 Feature로 활용하거나 두 모델의 결과를 결합하는 Hybrid GARCH-LSTM 구조도 연구할 수 있습니다.
실제로 학술 연구에서도 LSTM과 GARCH 계열 모델을 결합해 변동성을 예측하려는 접근이 꾸준히 연구되어 왔습니다.
LSTM vs GARCH, 결국 무엇을 확인해야 할까?
결국 LSTM과 GARCH의 예측 성능 비교에서 중요한 것은 단순히 누가 이겼느냐가 아닙니다.
어떤 데이터를 사용했고, 무엇을 예측했고, 미래 정보가 들어가지 않았는지,어떤 방식으로 검증했고, 보지 못한 새로운 데이터에서도 결과가 유지됐는지를 함께 봐야 합니다.
특히 백테스트 결과가 예상보다 지나치게 좋다면 바로 투자 전략으로 연결하기 전에 데이터 누수와 과적합부터 확인해보는 것이 좋습니다.
반대로 LSTM 결과가 기대보다 좋지 않다고 해서 딥러닝이 금융시장에 쓸모없다고 결론 내리는 것도 성급합니다.
Target 설정이나 Feature 구성, Lookback 기간, 모델 구조, Forecast Horizon 또는 시장 구간에 따라 결과가 달라질 수 있기 때문입니다.
GARCH 역시 마찬가지입니다.
GARCH(1,1), EGARCH, GJR-GARCH 등 어떤 구조를 사용했는지와 오차분포를 어떻게 설정했는지에 따라 결과가 달라질 수 있습니다.
그래서 금융 시계열 모델에서 가장 경계해야 하는 것은 예상보다 낮은 정확도가 아니라 과거 데이터를 너무 잘 설명하는 결과를 미래에도 그대로 재현할 수 있다고 믿는 것일 수 있습니다.
좋은 금융 예측 모델은 과거 그래프를 가장 멋지게 맞추는 모델이라기보다, 보지 못한 데이터에서도 반복적인 검증을 견디는 모델에 더 가깝습니다.
LSTM이 GARCH보다 정확하다? 예측 성능 비교할 때 주의할 점
자주 묻는 질문 Q&A
Q1. LSTM의 RMSE가 GARCH보다 낮으면 LSTM이 더 정확한 것 아닌가요?
동일한 Target, 동일한 기간, 동일한 Forecast Horizon과 평가 기준을 사용했다면 해당 실험 구간에서는 LSTM의 예측오차가 더 작았다고 표현할 수 있습니다.
다만 그것만으로 다른 시장이나 미래 기간에서도 LSTM이 계속 더 정확하다고 일반화하기는 어렵습니다.
Q2. 주가 예측에는 LSTM, 변동성 예측에는 GARCH를 쓰면 되나요?
그렇게 단순하게 나눌 필요는 없습니다.
LSTM 역시 목표변수를 어떻게 구성하느냐에 따라 변동성을 예측할 수 있으며 GARCH 계열과 LSTM을 결합하는 방법도 연구되고 있습니다.
중요한 것은 모델 이름보다 내가 무엇을 예측하려는지입니다.
Q3. 백테스트 성능이 너무 높게 나오면 무엇부터 확인해야 하나요?
먼저 데이터 누수 여부와 Train/Test 분리 방법을 확인해보는 것이 좋습니다.
이후 정규화 과정, Feature 생성 시점, 하이퍼파라미터 튜닝 과정, 과적합 여부를 살펴보고 Walk-Forward 방식에서도 결과가 유지되는지 확인할 필요가 있습니다.
참고자료
Francis X. Diebold, “Comparing Predictive Accuracy, Twenty Years Later”, NBER Working Paper 18391, 2012.
Kim & Won, “Forecasting the volatility of stock price index: A hybrid model integrating LSTM with multiple GARCH-type models”, Expert Systems with Applications, 2018.
Fischer & Krauss, “Deep learning with long short-term memory networks for financial market predictions”, European Journal of Operational Research, 2018.
※ 본 글은 LSTM, GARCH 및 금융 시계열 분석 방법을 설명하기 위한 일반적인 정보 제공 콘텐츠입니다. 특정 주식, ETF 또는 금융상품의 매수·매도를 권유하거나 미래 수익률을 보장하는 내용이 아닙니다. SPY, QQQ, AAPL, NVDA 등의 종목명과 티커는 분석 방법을 설명하기 위한 예시입니다. 실제 투자 결과는 시장 상황, 분석 기간, 거래비용, 세금, 모델 설정 등에 따라 달라질 수 있으며 과거 데이터에 기반한 백테스트와 예측 결과가 미래 성과를 보장하지 않습니다.
금알남


댓글 0
첫 댓글을 남겨보세요.