
파이썬 금융 데이터 분석 시계열 전처리부터 뉴스 감성 분석까지
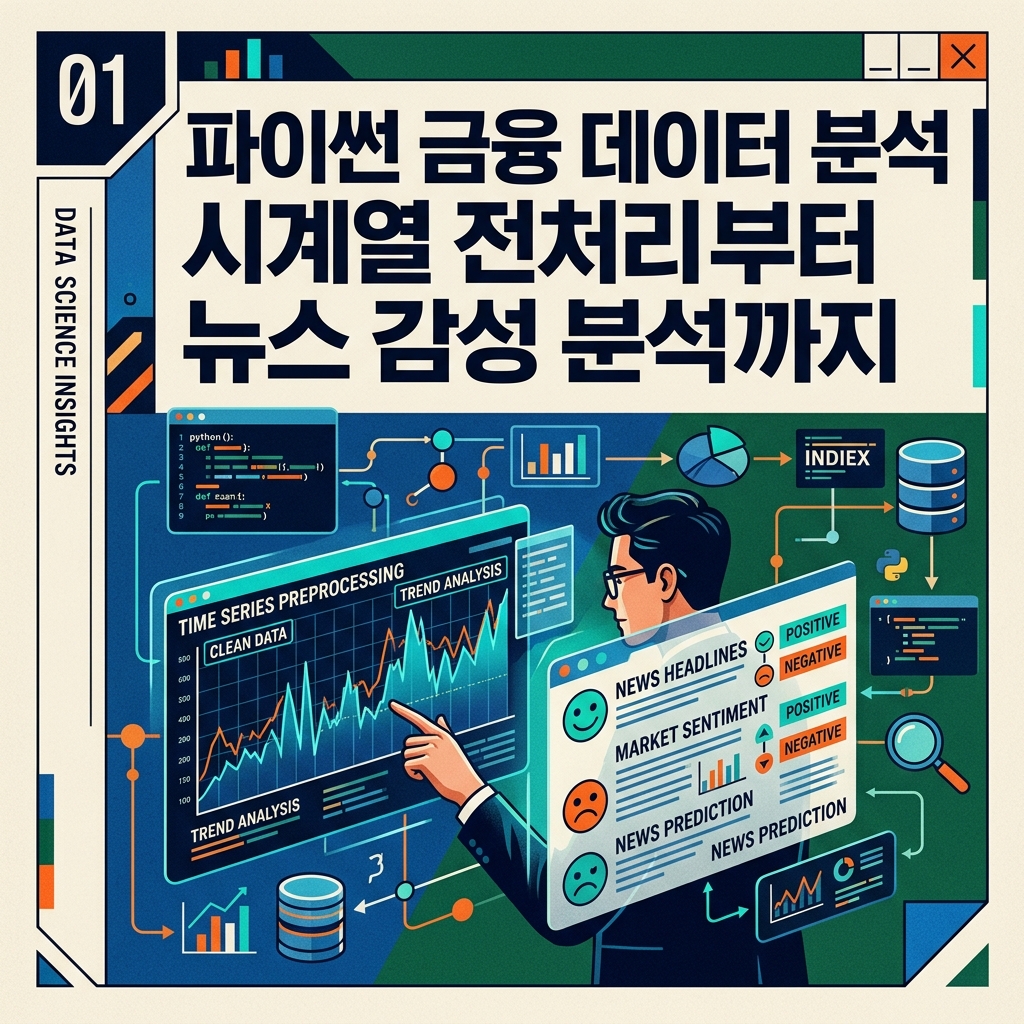
금융 시계열을 분석할 때 필요한 결측치 처리, 수익률 변환, 정상성 검정부터 뉴스 감성 점수 결합까지 순서대로 정리한 자료이며 뉴스 감성 데이터를 주가나 금리 데이터와 결합할 때 발생하기 쉬운 시점 오류와 데이터 누수 문제까지 함께 설명한 글입니다. 금융 데이터 분석을 처음 시작한다면 모델 선택보다 먼저 어떤 전처리와 검증 구조를 만들어야 하는지 확인해보시면 도움이 될 겁니다.
파이썬으로 주가나 금리 데이터를 불러와 그래프를 그리는 것까지는 생각보다 어렵지 않습니다.
문제는 그다음입니다.
결측값은 어떻게 처리해야 할까요? 주가 자체를 분석해야 할까요, 수익률로 바꿔야 할까요? 매일 쏟아지는 경제 뉴스는 숫자로 어떻게 변환할 수 있을까요?
그리고 가장 중요한 질문이 하나 있습니다.
내가 만든 분석 결과가 정말 의미가 있는 것인지, 아니면 미래 데이터를 미리 본 상태에서 만들어진 착시인지 어떻게 구분할 수 있을까요?
금융 데이터 분석에서는 복잡한 인공지능 모델보다 이러한 기본적인 데이터 처리 과정이 더 중요할 때가 많습니다.
이번 글에서는 파이썬을 이용해 금융 시계열 데이터를 정리하는 과정부터 비정형 경제 뉴스의 감성을 수치화하고, 두 데이터를 시간 기준으로 결합해 검증하는 방법까지 하나의 흐름으로 정리해보겠습니다.
1. 금융 데이터 분석은 전처리에서 시작된다
금융 데이터에는 크게 두 종류가 있습니다.
첫 번째는 숫자로 정리된 정형 데이터입니다.
주가, 거래량, 환율, 기준금리, 물가상승률, 실업률처럼 날짜와 값이 일정한 구조를 가지고 있는 데이터입니다.
두 번째는 구조가 일정하지 않은 비정형 데이터입니다.
경제 기사 제목과 본문, 기업 공시, 중앙은행 발표문, 애널리스트 리포트 등이 여기에 해당합니다.
예를 들어 주식시장을 분석한다고 생각해보겠습니다.
우리는 다음과 같은 정보를 동시에 사용할 수 있습니다.
- 날짜별 종가와 거래량
- 금리와 환율
- 소비자물가지수와 고용지표
- 해당 날짜에 발표된 경제 뉴스
- 뉴스에서 추출한 긍정·부정 감성
미국 거시경제 자료가 필요하다면 미국 세인트루이스 연방준비은행의 FRED와 같은 경제 데이터 서비스를 활용할 수 있습니다. FRED API는 경제 시계열의 관측값을 프로그램으로 가져올 수 있도록 제공됩니다.
데이터를 가져왔다면 가장 먼저 날짜를 통일해야 합니다.
import pandas as pd

df = pd.read_csv("market_data.csv")

df["date"] = pd.to_datetime(df["date"])
df = df.sort_values("date")
df = df.drop_duplicates(subset="date")

print(df.head())pd.to_datetime()을 이용하면 문자열 형태의 날짜를 pandas가 처리할 수 있는 날짜 자료형으로 변환할 수 있습니다.
pandas는 날짜 파싱, 날짜 범위 생성, 빈도 변환 등 시계열 데이터를 다루기 위한 기능을 공식적으로 제공하고 있습니다.
여기서 중요한 것은 단순히 날짜를 바꾸는 것이 아닙니다.
데이터가 실제 시간 순서대로 정렬되어 있는지 반드시 확인해야 합니다.
금융 시계열에서는 오늘의 데이터가 어제보다 먼저 위치해 있으면 이후 수익률 계산이나 지연 변수 생성 과정에서 잘못된 결과가 만들어질 수 있기 때문입니다.
2. 결측치와 수익률, 정상성을 어떻게 처리할까
금융 데이터를 가져오다 보면 빈 값이 자주 발생합니다.
주식시장은 주말이나 휴일에 거래되지 않지만 경제지표는 월별 또는 분기별로 발표됩니다.
따라서 여러 데이터를 합치면 자연스럽게 결측값이 생깁니다.
먼저 확인합니다.
print(df.isna().sum())상황에 따라 다음과 같은 방법을 선택할 수 있습니다.
df = df.dropna()

df["rate"] = df["rate"].ffill()

df["value"] = df["value"].interpolate()
pandas는 dropna, fillna, ffill, bfill, interpolate 등 다양한 결측치 처리 방식을 제공합니다.
하지만 여기서 중요한 점이 있습니다.
결측값을 무조건 채우면 안 됩니다.
예를 들어 아직 발표되지 않은 경제지표를 미래 값으로 채워 과거 시점에 넣어버리면 미래 정보를 미리 사용한 것과 같은 문제가 생길 수 있습니다.
금융 분석에서는 이런 현상을 데이터 누수, 즉 Data Leakage 문제로 볼 수 있습니다.
주가 역시 가격 자체보다 수익률로 변환해 분석하는 경우가 많습니다.
단순 수익률은 다음과 같이 계산할 수 있습니다.
df["return"] = df["close"].pct_change()로그 수익률도 자주 사용됩니다.
import numpy as np

df["log_return"] = np.log(
    df["close"] / df["close"].shift(1)
)
왜 굳이 가격을 수익률로 바꿀까요?
예를 들어 어떤 주가지수가 장기간 상승하고 있다면 가격 자체에는 강한 추세가 포함될 수 있습니다.
두 변수가 실제 관계가 없는데도 같이 상승한다는 이유만으로 높은 상관관계가 나오는 문제가 발생할 수도 있습니다.
따라서 시계열 모델을 사용하기 전에는 데이터의 정상성을 확인하는 과정이 중요합니다.
대표적인 방법 중 하나가 ADF, 즉 Augmented Dickey-Fuller 검정입니다.
from statsmodels.tsa.stattools import adfuller

series = df["log_return"].dropna()

result = adfuller(series)

print("ADF Statistic:", result[0])
print("p-value:", result[1])
ADF 검정은 시계열에 단위근이 존재하는지 평가할 때 사용되는 대표적인 통계 검정입니다. statsmodels에서도 관련 기능을 제공합니다.
다만 p-value 하나만 보고 데이터를 기계적으로 판단하는 것은 피하는 편이 좋습니다.
시계열 그래프, 추세, 계절성, 자기상관 구조 등을 함께 살펴봐야 합니다.
3. 경제 뉴스를 숫자로 바꾸는 감성 분석
이제 조금 더 흥미로운 부분입니다.
컴퓨터는 기본적으로 뉴스 문장의 경제적 의미를 바로 이해하지 못합니다.
따라서 뉴스 텍스트를 모델이 처리할 수 있는 형태로 바꿔야 합니다.
예를 들어 다음과 같은 기사가 있다고 가정해보겠습니다.
“물가 상승세가 예상보다 빠르게 둔화됐다.”
“중앙은행이 추가 긴축 가능성을 시사했다.”
두 문장은 같은 경제 뉴스지만 금융시장에 전달하는 뉘앙스는 상당히 다를 수 있습니다.
먼저 기본적인 텍스트 정제를 할 수 있습니다.
import re

def clean_text(text):
    text = re.sub(r"http\S+", "", text)
    text = re.sub(r"[^가-힣a-zA-Z0-9\s]", " ", text)
    text = re.sub(r"\s+", " ", text)

    return text.strip()

news["clean_title"] = news["title"].apply(clean_text)
그다음 감성 분석 모델을 이용해 각각의 뉴스에 점수를 부여할 수 있습니다.
금융 분야에서는 일반적인 영화 리뷰용 감성 분석 모델보다 금융 문장으로 학습되거나 미세조정된 모델을 고려할 수 있습니다.
대표적으로 FinBERT 계열 모델은 금융 텍스트에서 긍정·부정·중립과 같은 감성을 분류하기 위한 용도로 활용됩니다. 공개된 FinBERT 모델 카드에서도 금융 커뮤니케이션 자료를 활용한 금융 자연어 처리 목적을 설명하고 있습니다.
Transformers 라이브러리를 이용한 기본 구조는 다음처럼 만들 수 있습니다.
from transformers import pipeline

sentiment_model = pipeline(
    "sentiment-analysis",
    model="사용할_금융_감성분석_모델"
)

result = sentiment_model(
    "Economic growth remains strong."
)

print(result)
다만 여기서 주의할 점이 있습니다.
영문 금융 데이터로 학습된 모델에 한국어 경제 기사를 그대로 입력한다고 해서 좋은 결과가 나오는 것은 아닙니다.
한국어 뉴스라면 한국어 처리 능력이 있는 모델을 활용하거나, 금융·경제 문장에 맞게 추가 학습된 모델을 검토하는 것이 좋습니다.
또 하나의 중요한 문제는 문맥입니다.
“금리 인하 기대가 약화됐다”라는 문장을 단순히 ‘금리 인하’라는 단어만 보고 긍정으로 분류해서는 안 됩니다.
따라서 실제 분석에서는 모델 정확도를 별도의 검증 데이터로 평가하는 과정이 필요합니다.
감성 결과를 숫자로 변환하면 활용하기 편합니다.
예를 들어 단순화해서 다음과 같이 정할 수 있습니다.
score_map = {
    "positive": 1,
    "neutral": 0,
    "negative": -1
}

news["sentiment_score"] = (
    news["sentiment"]
    .map(score_map)
)
이후 하루에 뉴스가 여러 개 있다면 날짜별 평균을 계산합니다.
daily_sentiment = (
    news
    .groupby("date")["sentiment_score"]
    .mean()
    .reset_index()
)
그러면 뉴스라는 비정형 데이터가 날짜별 감성지수라는 정형 시계열 데이터로 바뀝니다.
4. 뉴스 감성과 금융 시계열을 결합할 때 가장 중요한 것
이제 시장 데이터와 뉴스 감성 데이터를 합쳐보겠습니다.
final_df = pd.merge(
    df,
    daily_sentiment,
    on="date",
    how="left"
)
여기까지만 보면 매우 간단합니다.
하지만 실전에서는 날짜보다 더 중요한 것이 시간입니다.
예를 들어 주식시장 종가를 예측한다고 가정해보겠습니다.
장 마감 이후 오후에 발표된 뉴스를 같은 날짜의 종가 예측 변수로 사용했다면 어떻게 될까요?
실제 투자 시점에서는 알 수 없었던 정보를 사용한 셈이 됩니다.
이것이 금융 머신러닝에서 특히 주의해야 하는 미래 정보 참조 문제입니다.
따라서 뉴스의 날짜만 저장하지 말고 실제 발표 시각까지 보관하는 편이 좋습니다.
또한 목표 변수도 명확하게 만들어야 합니다.
final_df["next_return"] = (
    final_df["return"].shift(-1)
)
이렇게 하면 오늘까지 알고 있는 정보를 이용해 다음 거래일 수익률과의 관계를 살펴볼 수 있습니다.
단순한 상관관계를 확인해볼 수도 있습니다.
corr = final_df[
    ["sentiment_score", "next_return"]
].corr()

print(corr)
하지만 상관계수가 높다고 바로 예측력이 있다고 결론 내려서는 안 됩니다.
훈련 데이터와 테스트 데이터를 나누는 과정도 시간 순서를 유지해야 합니다.
일반적인 머신러닝에서는 데이터를 무작위로 섞어 K-fold 교차검증을 사용하기도 하지만 시계열 데이터에서는 이러한 방식이 적절하지 않을 수 있습니다.
scikit-learn의 TimeSeriesSplit은 앞선 데이터를 학습 데이터로 사용하고 이후 데이터를 테스트 데이터로 사용하는 방식으로 시계열 순서를 유지하도록 설계되어 있습니다.
예를 들어 다음과 같습니다.
from sklearn.model_selection import TimeSeriesSplit

X = final_df[
    ["sentiment_score", "return"]
].dropna()

tscv = TimeSeriesSplit(n_splits=5)

for train_idx, test_idx in tscv.split(X):

    train = X.iloc[train_idx]
    test = X.iloc[test_idx]

    print(
        len(train),
        len(test)
    )
금융 데이터 분석에서 상당히 위험한 실수가 바로 데이터 전체를 무작위로 섞은 뒤 높은 정확도가 나왔다고 판단하는 것입니다.
미래 시점의 패턴이 학습 데이터에 들어간다면 실제 운용에서는 재현되지 않는 성능이 나타날 수 있습니다.
그래서 금융 머신러닝에서는 모델이 얼마나 복잡한가보다 데이터가 시간 순서에 맞게 분리되었는지 먼저 확인하는 습관이 중요합니다.
5. 시계열과 뉴스 감성 분석을 함께 사용할 때 확인할 것
금융 데이터 분석을 처음 접하면 좋은 알고리즘부터 찾는 경우가 많습니다.
랜덤포레스트가 좋은지, XGBoost가 좋은지, LSTM이나 Transformer를 사용해야 하는지가 먼저 궁금해집니다.
하지만 실제 분석 순서는 그 반대에 가깝습니다.
먼저 데이터가 무엇을 의미하는지 확인해야 합니다.
날짜가 제대로 정렬되어 있는지, 결측치를 어떤 방식으로 처리했는지, 가격을 그대로 사용할지 수익률로 변환할지, 뉴스 발표 시점과 시장 거래 시점이 정확히 맞는지를 확인한 뒤 모델을 선택해야 합니다.
특히 다음 질문은 분석 전에 스스로 확인해볼 가치가 있습니다.
- 미래 시점의 데이터를 실수로 사용하고 있지는 않은가?
- 결측값을 채우는 과정에서 미래 값이 과거로 넘어오지는 않았는가?
- 뉴스가 실제 공개된 시각을 반영했는가?
- 감성 분석 모델이 해당 언어와 금융 분야에 적합한가?
- 주가 수준이 아니라 수익률과 변화율을 살펴볼 필요는 없는가?
- 학습 데이터와 테스트 데이터가 시간 순서대로 구분되어 있는가?
- 높은 정확도가 실제 새로운 기간에서도 유지되는가?
이 질문에 답할 수 있어야 분석 결과에 대한 신뢰도도 높아집니다.
결국 파이썬 금융 데이터 분석의 핵심은 단순히 많은 데이터를 모으는 데 있지 않습니다.
정형 시계열 데이터와 비정형 뉴스 데이터를 같은 시간축 위에 올려놓고, 각 정보가 실제 당시 이용할 수 있었던 정보인지 확인하면서 검증하는 과정이 중요합니다.
처음에는 주가지수 하나와 뉴스 제목만으로 시작해도 충분합니다.
시계열 데이터를 정리하고, 뉴스 감성을 점수화하고, 두 데이터 사이에 시차를 두어 관계를 비교하다 보면 자연스럽게 금리, 환율, 물가, 고용지표 등 다양한 거시경제 변수로 분석 범위를 확장할 수 있습니다.
복잡한 모델을 먼저 만드는 것보다 데이터의 시간 구조를 이해하는 것이 좋은 금융 데이터 분석의 출발점입니다.
참고 자료
pandas 공식 문서: Time series / date functionality, Missing data handling
statsmodels 공식 문서: Augmented Dickey-Fuller 관련 기능
scikit-learn 공식 문서: TimeSeriesSplit
Federal Reserve Bank of St. Louis: FRED API Documentation
Hugging Face 공개 금융 감성 분석 모델 자료: FinBERT 관련 모델 카드
금융소비자보호 및 개인 유의사항
본 글은 파이썬을 활용한 금융·경제 데이터 분석 방법을 설명하기 위한 교육 및 정보 제공 목적의 콘텐츠이며, 특정 금융상품의 가입·매수·매도 또는 투자 행위를 권유하기 위한 글이 아닙니다.
데이터 분석 결과와 과거의 통계적 관계가 향후 시장 움직임이나 투자 성과를 보장하지 않습니다. 실제 투자 또는 금융상품 선택 시에는 개인의 재무상황, 투자목적, 위험수용도 및 해당 상품의 설명서와 약관 등을 충분히 확인한 후 판단해야 합니다.
금융 관련 데이터와 뉴스는 발표 이후 수정될 수 있으며, 데이터 수집 시점·전처리 방법·모델·분석 기간에 따라 결과가 달라질 수 있습니다.
금알남


댓글 0
첫 댓글을 남겨보세요.